
As pesquisas de Joy Buolamwini expõem falhas nos sistemas de reconhecimento facial e mostram como a tecnologia pode reproduzir desigualdades raciais.
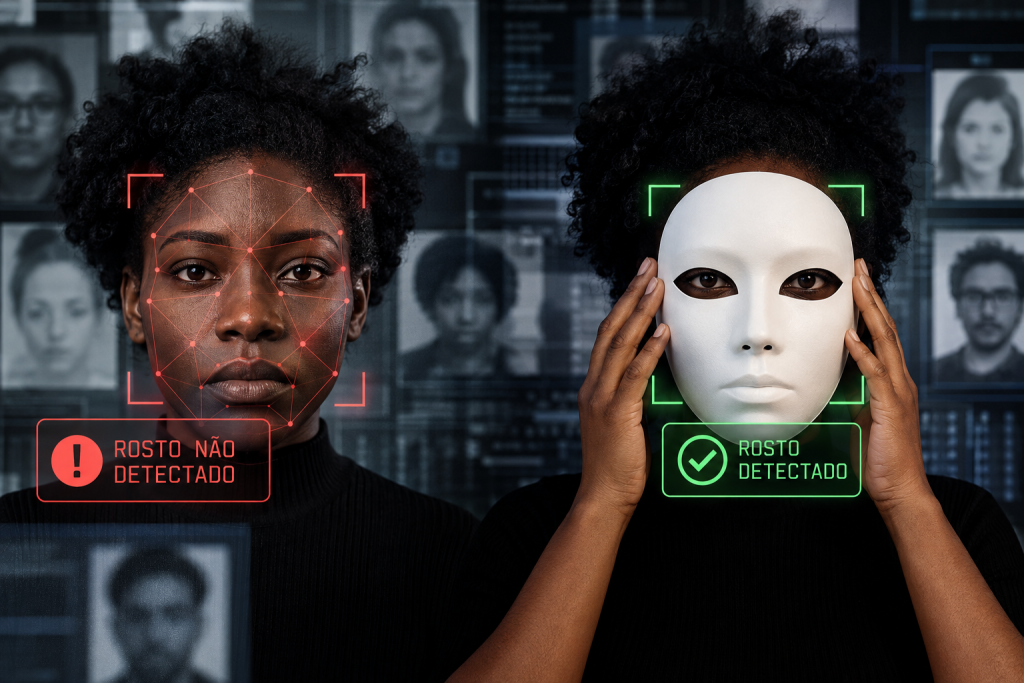
Uma mulher negra está diante de uma câmera. O sistema de inteligência artificial não consegue detectar seu rosto. Ela tenta novamente, muda de posição, ajusta a iluminação. Nada acontece. Ao colocar uma máscara branca, finalmente é reconhecida pela máquina.
A cena aconteceu com Joy Buolamwini, pesquisadora ganesa-americana do Instituto de Tecnologia de Massachusetts (MIT), durante seus experimentos com tecnologias de análise facial. A experiência despertou uma inquietação que daria origem a uma pesquisa sobre discriminação algorítmica.
Como uma tecnologia desenvolvida para reconhecer rostos humanos poderia apresentar resultados tão diferentes dependendo da cor da pele?
Em 2018, Buolamwini e a cientista da computação Timnit Gebru publicaram o estudo Gender Shades, no qual avaliaram três sistemas comerciais de classificação de gênero a partir de imagens faciais. Os resultados foram preocupantes. Enquanto as taxas de erro para homens de pele clara não ultrapassavam 0,8%, para mulheres de pele escura chegavam a 34,7%.
Os sistemas avaliados não realizavam identificação individual, mas classificação de gênero. Essa distinção importa para compreender o alcance da pesquisa. O estudo demonstrou que ferramentas de análise facial apresentavam diferenças expressivas de precisão entre grupos demográficos.
Os resultados colocaram em xeque a confiança depositada em sistemas automatizados e ajudaram a dar visibilidade ao racismo algorítmico.
O termo descreve situações em que sistemas computacionais produzem, reproduzem ou intensificam desigualdades raciais. Isso pode acontecer mesmo quando seus desenvolvedores não têm a intenção explícita de discriminar.
Os algoritmos aprendem a partir de dados selecionados por pessoas. Se uma base de treinamento apresenta predominância de rostos de pessoas brancas, por exemplo, o sistema pode ter mais dificuldade para reconhecer características de outros grupos. A composição dos dados, entretanto, é somente uma parte do problema. Também contam as categorias escolhidas, os critérios de avaliação e as condições em que a tecnologia será utilizada.
Um sistema pode apresentar uma taxa média de acerto considerada satisfatória e, ainda assim, errar com frequência muito maior para determinados grupos. Quando as empresas divulgam apenas indicadores gerais de desempenho, essas diferenças podem permanecer escondidas.
Em 2019, o Instituto Nacional de Padrões e Tecnologia dos Estados Unidos (NIST) publicou uma investigação sobre os efeitos de características demográficas no desempenho de sistemas de reconhecimento facial. Foram avaliados 189 algoritmos de 99 desenvolvedores. Os pesquisadores encontraram diferenças nas taxas de erro associadas a características como raça, idade e sexo, embora os resultados variassem conforme o algoritmo e a aplicação.
A pesquisa de Buolamwini e os estudos posteriores ajudaram a demonstrar que a discriminação algorítmica pode ser examinada empiricamente. É possível medir disparidades, identificar padrões de erro e exigir explicações de quem desenvolve e comercializa essas tecnologias.
Uma pesquisadora que também escreve poesia
Joy Buolamwini ficou conhecida como Poet of Code, ou Poeta do Código. O nome traduz uma característica de seu trabalho: a combinação de pesquisa científica, poesia e ativismo.
Fundadora da Algorithmic Justice League, organização voltada à investigação dos danos provocados por sistemas algorítmicos, Buolamwini utiliza diferentes linguagens para discutir as consequências sociais da inteligência artificial.
Sua trajetória ganhou visibilidade internacional com o documentário Coded Bias, lançado em 2020, e com o livro Unmasking AI: My Mission to Protect What Is Human in a World of Machines, publicado em 2023.
A poesia ocupa um lugar particular nessa produção. Buolamwini utiliza a expressão artística para tratar de questões que, apresentadas exclusivamente em artigos científicos, dificilmente alcançariam públicos mais amplos.
A escolha tem relação com o próprio problema que investiga. Os números revelam diferenças de desempenho entre sistemas, mas dizem pouco sobre a experiência de quem é prejudicado por essas falhas. A arte permite abordar a dimensão humana de um problema frequentemente apresentado em termos estatísticos.
Seu trabalho também questiona a concentração das discussões sobre inteligência artificial nas empresas de tecnologia e nos laboratórios de computação. Os sistemas desenvolvidos nesses ambientes interferem na vida de pessoas que não participaram das decisões sobre sua criação e utilização.
Quem decide quais dados serão utilizados? Quais grupos participam dos testes? Quem estabelece o que é um erro aceitável? E quem responde quando uma decisão automatizada provoca prejuízos?
São perguntas que envolvem diferentes áreas do conhecimento e exigem participação pública.
O preconceito pode estar escondido nos dados
Existe uma tendência a considerar os resultados produzidos por computadores mais objetivos do que aqueles elaborados por pessoas. A máquina processa informações, realiza cálculos e apresenta uma resposta. A aparência de precisão matemática pode dificultar o questionamento do resultado.
Entretanto, os sistemas de inteligência artificial são desenvolvidos dentro de organizações, com objetivos específicos, limitações técnicas e decisões humanas.
Um algoritmo utilizado em processos seletivos, por exemplo, pode aprender padrões presentes em contratações anteriores. Se o histórico da empresa contém práticas discriminatórias, existe o risco de que esses padrões sejam reproduzidos nas recomendações automatizadas.
O mesmo raciocínio se aplica a ferramentas utilizadas para avaliar riscos, organizar informações ou classificar pessoas. Cada aplicação apresenta características próprias, mas todas exigem atenção aos dados utilizados e aos critérios que orientam seus resultados.
O problema se agrava quando a decisão automatizada passa a ser tratada como uma justificativa suficiente. O candidato foi rejeitado porque o sistema atribuiu uma pontuação baixa. O cliente teve uma solicitação recusada porque o algoritmo identificou determinado risco. A responsabilidade humana desaparece atrás de uma explicação técnica.
A expressão “foi o algoritmo que decidiu” tornou-se uma maneira conveniente de afastar a responsabilidade de quem escolheu utilizar determinada tecnologia.
É preciso identificar quem desenvolveu o sistema, quem autorizou sua aplicação, quais informações foram utilizadas e quais mecanismos existem para corrigir decisões equivocadas.
O que a educação midiática tem a ver com isso?
A discussão sobre racismo algorítmico deveria estar presente nas escolas e universidades.
Durante muito tempo, a educação midiática concentrou esforços na leitura crítica dos meios de comunicação, na análise das mensagens publicitárias e, posteriormente, no enfrentamento da desinformação nas plataformas digitais.
A presença crescente da inteligência artificial exige que esse trabalho alcance também os sistemas que selecionam, classificam e recomendam informações.
Quando um estudante utiliza uma ferramenta de inteligência artificial para pesquisar determinado assunto, recebe uma resposta produzida a partir de processos que dificilmente consegue observar. O conteúdo pode parecer confiável pela fluidez da linguagem, mesmo quando apresenta erros, omissões ou interpretações enviesadas.
Compreender essas limitações faz parte da formação crítica.
O estudo de Joy Buolamwini oferece um exemplo concreto para atividades de educação midiática. A análise dos resultados de Gender Shades permite discutir representação nos bancos de dados, critérios de classificação, desigualdades sociais e responsabilidade tecnológica.
Também abre espaço para uma discussão sobre comunicação. Afinal, a maneira como empresas apresentam seus sistemas interfere na percepção pública sobre sua confiabilidade. Expressões como “inteligência”, “autonomia” e “precisão” podem sugerir capacidades que precisam ser examinadas com cuidado.
As universidades têm responsabilidade nesse debate. Estudantes de Jornalismo, Relações Públicas, Publicidade, Educação, Administração e Tecnologia precisam compreender como decisões automatizadas podem afetar públicos diferentes.
Profissionais de comunicação, especialmente, devem saber questionar informações fornecidas por empresas que desenvolvem ou utilizam inteligência artificial. Divulgar uma tecnologia como eficiente sem examinar seus limites pode contribuir para naturalizar práticas discriminatórias.
Quando a tecnologia erra, quem responde?
O trabalho de Joy Buolamwini ajuda a compreender por que a avaliação da inteligência artificial não pode ficar restrita à eficiência dos sistemas.
Uma ferramenta de reconhecimento facial pode apresentar avanços expressivos de precisão e continuar sendo utilizada em práticas de vigilância que afetam desproporcionalmente determinados grupos sociais. A redução dos erros técnicos não resolve, necessariamente, os problemas associados à finalidade de uso.
Essa distinção merece atenção. Uma tecnologia pode funcionar exatamente como foi projetada e ainda produzir consequências socialmente questionáveis.
A pesquisa sobre racismo algorítmico exige que observemos tanto o funcionamento dos sistemas quanto as relações de poder que orientam sua aplicação.
No caso de Buolamwini, uma experiência pessoal diante de uma câmera levou à produção de evidências científicas que questionaram o desempenho de tecnologias comercializadas por grandes empresas. Sua atuação contribuiu para ampliar a cobrança por testes mais representativos, transparência e responsabilização.
Há algo especialmente perturbador na imagem da pesquisadora precisando colocar uma máscara branca para ser reconhecida por uma máquina. O episódio materializa uma desigualdade que poderia passar despercebida em relatórios técnicos.
A inteligência artificial continuará sendo incorporada a atividades profissionais, serviços públicos e práticas cotidianas. Precisamos saber como esses sistemas funcionam, quais interesses orientam sua utilização e quem está sujeito aos seus erros.
Quando uma tecnologia apresenta resultados diferentes conforme a cor da pele, a discussão não pode terminar com a promessa de uma atualização do software. É necessário investigar por que a desigualdade ocorreu, quais consequências produziu e quem deve responder por ela.
Afinal, reconhecer um rosto é uma tarefa computacional. Reconhecer os direitos de quem está diante da câmera continua sendo uma responsabilidade humana.